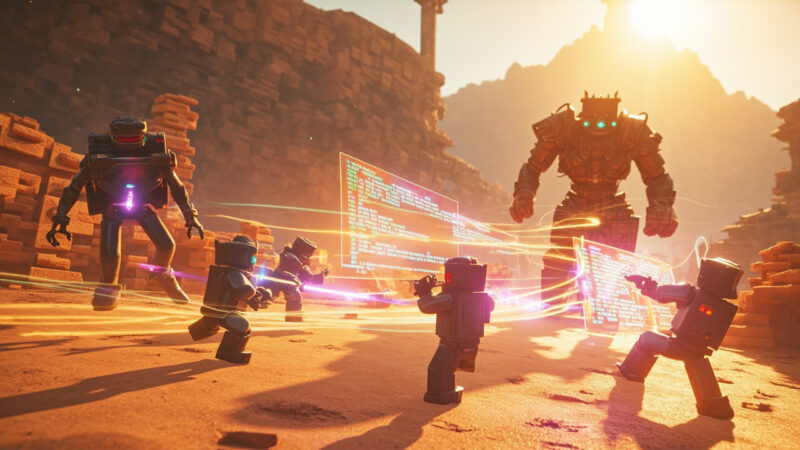
36氪报道中,4个AI Agent进入《我的世界》,累计死亡605次,期间自主编写代码,最终击败Boss。 但“死亡605次”首先是一份运行统计,不等于进行了605轮模型训练,公开信息也没有证明每次死亡都触发了参数更新。
核心机制可以概括为:Agent把目标转成受控代码,在游戏接口上执行,再根据异常和状态变化修改方案。真正值得关注的不是角色死了多少次,而是代码能否稳定运行、失败能否转化为修正,以及系统是否用外部状态确认完成。
四个Agent到底负责什么?
现有公开信息没有完整披露四个实例与具体职责的一一对应关系、共享记忆格式及通信协议,因此不能把其他Minecraft项目的角色设定直接移植过来。 从任务闭环看,至少需要四类功能:
| 功能环节 | 输入 | 输出 |
|---|---|---|
| 目标拆解 | 总目标、当前状态、约束 | 子目标、完成条件 |
| 代码生成 | 子任务、允许调用的接口、历史错误 | 可执行代码 |
| 运行排错 | 代码、返回值、异常、状态变化 | 错误摘要、修正代码或重试请求 |
| 状态验收 | 目标定义、最终游戏状态 | 完成、未完成或重新规划 |
这是一套功能抽象,不等于四个Agent的官方命名。实际交接应当携带状态版本、子任务编号、代码版本和执行结果,否则某个Agent即使生成了正确代码,也可能基于过期状态继续操作。
作为对照,其他Minecraft Agent项目会把模型决策与确定性执行器分开,由模型选择动作、代码执行具体操作;ADAM则采用交互、因果模型、控制器和感知四模块架构。 这些设计可用于理解模块边界,但不能据此认定本次谷歌实验采用了相同方案。
生成的代码怎么跑起来并改错?
完整链路可以简化为:
读取状态 → 拆解目标 → 生成代码 → 沙箱执行
   ↑                         ↓
验证结果 ← 修改并重试 ← 异常、返回值和游戏反馈
模型不能任意操作电脑,而应只调用预先定义的Minecraft控制接口。沙箱负责限制执行时间、文件权限、网络访问和资源占用,并返回三类反馈:代码异常、接口返回值,以及执行前后的游戏状态差异。
长链路任务需要区分三种“成功”:代码能够解析和运行,只代表第一层;动作确实改变了预期状态,代表第二层;最终目标的状态条件成立,才代表任务完成。因此,在这类长链路实验中,不能把“没有抛异常”直接当成任务完成。模型负责决策、程序负责执行,是更稳妥的边界。
605次死亡究竟带来了什么学习?
605次死亡记录可能对应至少四类问题:
- 游戏内死亡:需要从死亡位置、血量和敌人状态重新规划路线或战斗策略。
- 代码或接口错误:语法错误、运行异常、参数不合法,应通过报错定位并修改代码。
- 代码有效但策略无效:程序正常执行,角色却没有靠近目标、收集资源或减少Boss血量。
- 策略僵局或交接失败:Agent重复相同动作,或多个Agent依据不同版本的状态继续工作。
持续失败时,策略僵局是长时任务需要防范的风险;重复尝试同一种方案并不会自动产生更好的行为。
判断系统是否真正“学习”,必须查看更具体的日志。若存在优化器记录、检查点变化或在线样本更新,才能确认参数训练;若共享记忆被写入并影响下一次规划,才是记忆更新;若代码版本随报错发生针对性变化,属于外部代码迭代;若输入、代码和动作基本不变,则只是重试。仅有605这个汇总数字,无法区分这四种情况。
最后一次运行为什么算赢?
报道确认最终击败了Boss,但没有充分说明结果由模型自报,还是由外部验证器检查。 是否获胜应依据Boss血量、环境事件、物品栏或目标方块等实际状态判断,并设置明确的终止条件;长链路Agent实验尤其不能只接受一句“任务已完成”。
超时、权限不足或连续报错也应记为失败,而不是提前结束并自报成功。
如何搭建最小验证系统?
开发者不必一开始就搭建四Agent。先准备一个可自动验证的沙箱任务,例如放置指定方块或取得固定资源,只设置一个“规划与代码生成Agent”和一个确定性“执行与验证器”:
while 未完成 and 未超时:
    state = observe()
    plan = agent.plan(goal, state, api_spec, last_error)
    code = agent.code(plan)
    result = sandbox.run(code, timeout=30)
    log(state, plan, code, result)
    done = verify(observe(), goal_spec)
同时锁定Minecraft版本、API版本和随机种子,限制网络与文件权限,并记录状态、提示词、代码、异常、状态差异、动作哈希、恢复步数和总耗时。评价时重点看任务成功率、首次可运行代码率、重复策略率、恢复步数与总耗时,而不只是死亡次数。
只有日志显示某个环节持续构成瓶颈时,才拆出第三个Agent。拆分Agent可以隔离不同类型的错误;但如果只是将Agent数量从两个增至四个,并增加消息传递和状态同步,可靠性未必更高。
[email protected]
。
我们承诺在核实信息后,将第一时间删除相关内容或断开链接。
暂无评论内容