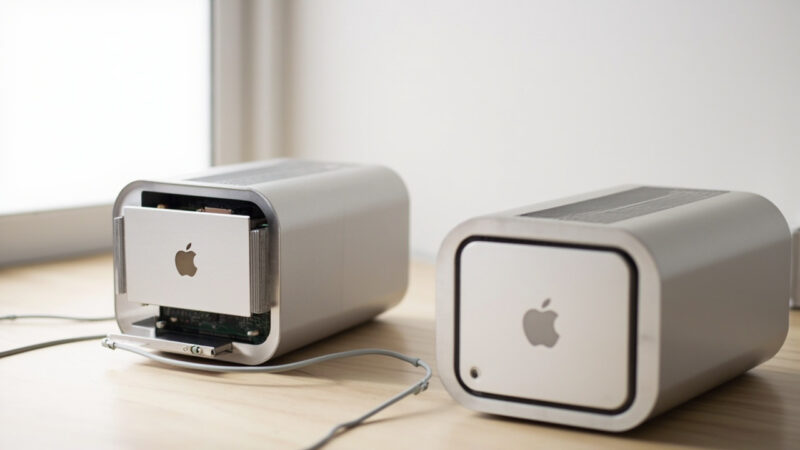

两台苹果电脑能否真正把一个8160亿参数的大模型完整跑起来——能,但前提是这两台都得是Apple尚未公开发售的512GB统一内存版Mac Studio(M5 Ultra)。Muse Spark Open的官方优化方案正是两台机器互联,每台装一半权重,再通过Apple Silicon统一内存的高带宽拼接成一个完整模型 [2]。如果你今天就想买,目前在售的最高规格是256GB统一内存版本,按”256GB + 1TB SSD”配置计算单台已超过1万美元,四台拼成约1TB内存集群的总购机成本超过4万美元 [2]。换句话说,Meta这张”双Mac Studio跑大模型”的名片,目前还是一个挂着”10月底开售”标签的期货式承诺。
但把眼光从营销话术往后挪一格,Muse Spark Open本身确实有点东西。它是一个原生多模态模型,采用MoE混合专家架构,总参数8160亿、活跃参数420亿、上下文窗口100万token,专门为编码与智能体任务设计 [2]。Meta同时把权重放到了NVIDIA、AMD芯片以及主流推理引擎上兼容,并没有把开发者锁死在苹果硬件里 [2]。
双Mac Studio跑8160亿模型,Meta是怎么做到的
把一个8160亿参数的模型塞进两台桌面工作站,并不是把显卡数量翻倍那么简单,关键在三件事的配合:MoE架构、统一内存、MLX框架。
首先是架构。Muse Spark Open走的是混合专家路线,8160亿是总参数,但每处理一个token时实际激活的只有420亿——大约5% [2]。这意味着模型绝大部分权重”躺”在内存里待命即可,不需要像稠密模型那样在每个推理步骤都把全部参数激活参与计算。MoE已经成为超大参数模型的标准做法,Meta在Llama 4系列上就已经全面转向这一架构 [4]。
其次是硬件。Apple Silicon的统一内存(Unified Memory)把CPU和GPU共享同一块大容量内存池,免去了传统显卡VRAM容量受限的瓶颈。M5 Ultra版Mac Studio官方最高支持512GB统一内存——这正是Meta选择它的原因:单台就能装下模型一半的权重,两台通过高速互联拼起来就能容纳完整8160亿参数 [2]。这个数字放在NVIDIA阵营里需要多张H100或者多节点服务器才能达到。
最后是软件层。Muse Spark Open用最新版MLX框架做了针对性优化。MLX是Apple开源的机器学习框架,专门为苹果芯片设计,Meta在公告中直接把它和M5 Ultra称为”在个人电脑上运行强大模型的最佳方案” [2]。同一套模型权重也兼容NVIDIA、AMD芯片以及主流推理引擎,Meta显然不想让开发者以为这是Apple独家方案 [2]。
把它冠上”美国最强”,但优势并不均匀
Meta把Muse Spark Open定位为”迄今能力最强的美国开放权重模型”,底气来自它自己公布的对比结果:在工作流、工具调用、知识推理、知识可靠性、复杂视觉推理和图像事实问答这6项测试中排名第一 [2]。
但同一份成绩单也坦承:在软件开发及其他部分任务上,Kimi、千问、智谱等中国开源模型依然更胜一筹 [2]。换言之,Muse Spark Open的领先是结构性的——它在智能体、知识类、视觉推理类工作上有优势,但落到纯软件工程这条传统强项赛道,中国阵营仍然占优。这与中国开源模型近两年在代码生成、Agent框架上集中发力的整体趋势是一致的。
Meta的措辞限定了”美国”二字。Llama 4时代,DeepSeek等中国开源力量已经全面崛起,把”开放权重模型”的全球第一梯队搅得相当拥挤——Llama 4 Behemoth的2万亿总参数虽然看起来惊人,但其真正对手其实是DeepSeek-R1(6710亿总参数)这一级别的中国模型 [4]。Meta这次的”美国最强”标签,本质上是在回避和DeepSeek、Kimi这种已经走出国门的玩家正面比较,把范围划定在”美国产”这个细分赛道内。
Meta和Apple这次怎么会站到一起
Meta和Apple的合作,放在十年前是不可想象的。扎克伯格和库克长期互怼——库克曾指责Meta侵犯用户隐私,扎克伯格则嘲讽过苹果”自iPhone之后就再也没有发明出任何了不起的东西” [2]。
但开源AI的共同利益把双方拽到了同一张桌子前。Meta需要证明自己的8160亿参数模型在能力上仍然有竞争力——尤其是在DeepSeek、Kimi等中国模型已经把开源天花板抬得很高的情况下 [2][4]。Apple则需要证明自己整套Mac软硬件体系适合本地跑AI,这关系到Apple Silicon在开发者群体中的长期定位 [2]。
Meta AI负责人汪滔在介绍这次合作时半开玩笑地说:”双方的大部分积怨都形成于我加入公司之前,但显然,Meta和苹果之间的恩怨由来已久。” [2] 另一个被点名的关键牵线人是Daniel Gross——Meta算力部门的联合负责人、前Apple资深总监。去年扎克伯格全面调整公司AI战略时,Gross与GitHub前CEO Nat Friedman一同成为重点招揽的人才 [2]。这种”两边都待过”的高管,是促成两家破冰的现实桥梁。
本地部署真实账本:单台近1万美元,1TB集群超4万美元
营销话术和现实之间还隔着一段距离。512GB统一内存版Mac Studio(M5 Ultra)目前并未公开发售,Meta在公告里写明的”10月底开售” [2],是开发者今天买不到的规格。
目前能立刻下单的最高配置是256GB统一内存版Mac Studio,”256GB + 1TB SSD”配置单台售价已超过1万美元 [2]。如果用四台256GB机器组成约1TB内存集群,总购机成本超过4万美元 [2]。
这个数字看着不便宜,但Meta的逻辑是:对长期需要租用云端算力的应用开发者而言,硬件费用有望通过节省下来的租赁费用逐步摊平 [2]。再加上数据本地化带来的隐私保障、不用跟云端供应商排队等GPU资源等因素,对一些特定场景——比如企业内部部署、对延迟敏感的应用、涉及敏感数据的推理——是有意义的。但对绝大多数个人开发者和中小团队来说,4万美元起步的本地集群依然是个不低的门槛,短期内恐怕还是云端按需租用更现实。
从Llama到Muse Spark Open,Meta押注开源走到哪一步
Muse Spark Open不是Meta第一次在开源上出牌,而是这条路线上最新的一颗棋子。
Llama 2是分水岭。2023年7月,Meta把Llama 2推向开源并允许免费商用,包含70亿、130亿、700亿三个参数版本 [3],训练token数2万亿、上下文窗口4096 [3]。微软同时成为Llama 2的首选合作伙伴,通过Azure云服务分发 [5]。Meta首席AI科学家杨立昆当时在推特上直言”这将改变LLM市场的格局” [5]。Llama 2的意义在于第一次让开放权重的大模型进入了合规商用轨道——之前的Llama 1虽然开源但限制非商业用途,权重甚至在发布后不久就被泄露到种子站点 [3]。
Llama 3.1 405B把开放权重推到了”前沿级”。2024年7月,Meta发布405B版本,号称首个开放源代码的前沿级AI模型,训练使用超过15万亿token和16000多张H100 GPU [6]。通过量化技术,405B模型可以在单个服务器节点上运行 [6]。这是Meta第一次证明开放权重模型的能力可以比肩顶级闭源模型。
Llama 4系列转向MoE架构。2025年4月,Meta发布Llama 4 Scout和Llama 4 Maverick两款MoE模型,并展示了预览版的2万亿参数Behemoth [4]。Llama 4 Scout支持1000万token上下文窗口,刷新了开源模型记录 [4]。架构上首次全面采用混合专家,与DeepSeek系列的路线一致 [4]。
Muse Spark Open是这条线上的最新落点。它把参数规模推到8160亿、把上下文拉到100万token、把优化重点放在编码与智能体上,并首次与Apple在硬件优化层面深度协作 [2]。在DeepSeek、Kimi、智谱、千问等中国开源模型已经从”追赶者”变成”并跑者”甚至”领跑者”的当下,Muse Spark Open更像是Meta对开放权重赛道最新的一次表态——能力上仍然能拿出东西,与Apple的合作则把”本地跑大模型”这件事从概念推到了工程落地。
FAQ
Muse Spark Open的权重在哪下载?商用授权怎么申请?
参考资料中没有给出具体的下载地址和授权流程的细节。根据Meta一贯的开源做法,权重通常会通过Hugging Face、Meta官方GitHub等渠道发布,商用条款一般会附带在许可证文件中——但本次发布的具体条款并未在所引用的资料中披露,建议直接关注Meta官方公告。
手上只有M3 Ultra或M4 Ultra的Mac,能跑Muse Spark Open吗?
MLX框架针对Apple Silicon做了通用优化,多代Apple Silicon从原理上看都应该能加载Muse Spark Open——但Meta官方明确推荐和测试的配置是M5 Ultra + 512GB统一内存 [2]。M3/M4 Ultra的内存上限和带宽都不及M5 Ultra,能不能完整加载8160亿参数、推理速度能不能接受,得等社区实测。参考资料里没有给出在M3/M4 Ultra上的官方基准数据。
把模型放到NVIDIA H100集群或AMD GPU上跑,速度会比双Mac Studio差很多吗?
参考资料中没有直接对比Muse Spark Open在NVIDIA H100、AMD GPU与双Mac Studio之间的推理速度基准。但从架构上看,H100等数据中心GPU在浮点算力和显存带宽上有传统优势,Apple Silicon的优势主要在统一内存的容量和能效比。实际表现取决于具体硬件配置、batch size、推理引擎优化程度,不能简单下结论,建议关注Meta后续发布的官方基准和社区实测。
参考来源
[1] 刚刚,Meta推出美国最强开源模型:8160亿参数,两台Mac
[2] Meta 发布美国最强开源大模型,”仅用”两台苹果电脑就能本地运行
[3] Meta 发布开源且可商用的 AI 模型 LIama 2-CSDN博客
[4] Meta,重磅发布!_Llama_模型_DeepSeek
[email protected]
。
我们承诺在核实信息后,将第一时间删除相关内容或断开链接。
暂无评论内容