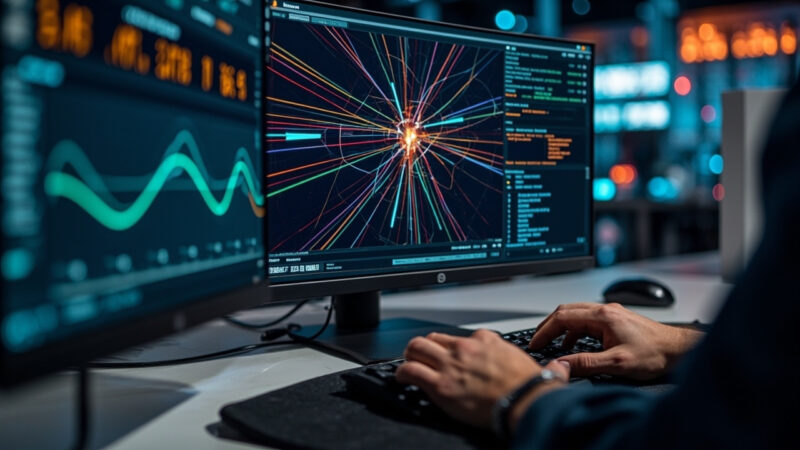
某个 API 的 P99 延迟从 200ms 升至 2 秒时,Prometheus 首先触发告警。追踪火焰图随后显示,80% 的耗时集中在优惠券服务里的 MySQL 查询上;团队再按同一 TraceID 检索日志,看到慢查询和索引缺失,并确认新代码引发了全表扫描。补上索引后,延迟恢复正常。
指标、追踪和日志各自不可替代,也必须协同:指标负责发现异常并划定范围,追踪负责还原调用路径和定位慢点,日志负责补齐代码、查询或配置层面的现场。Service Mesh 的价值在于由 Sidecar 在通信路径上统一提供这些数据;SkyWalking、Jaeger、Zipkin 等专项工具继续负责链路分析与展示,两者应当协同,而不是互相替代。
代理路径如何产出指标、追踪和访问日志
在 Sidecar 实际接管的范围内,进出服务的流量都要经过代理,因此代理处在采集可观测性数据的位置上。它既能统计请求量、延迟和响应状态,也能在调用发生时传播追踪上下文,还能输出访问日志。 代理由此可以统一采集三类信号,三类信号也能采用统一方案。
三类信号分别回答不同问题:
| 信号 | 首要回答的问题 | 典型产出 | 关联其他信号的字段 |
|---|---|---|---|
| 指标 | 哪个服务、何时开始异常,异常有多严重 | 请求量、延迟分布、错误率 | 服务名、时间窗口、响应状态 |
| 追踪 | 请求经过了哪些服务,慢在哪个调用,失败在哪里 | Trace、Span、父子关系、调用耗时 | TraceID、SpanID、服务名 |
| 日志 | 故障现场具体发生了什么 | SQL、异常堆栈、配置值、业务事件 | 时间戳、服务名、TraceID、SpanID |
指标擅长发现趋势,却不能说明一次请求为何变慢;追踪能够还原调用关系,却未必包含 SQL 文本或异常堆栈;日志拥有最多细节,但如果缺少稳定标识,就很难和指标、追踪自动对齐。 因此,统一采集只是第一步,三类信号还必须共享服务标识、时间窗口和 TraceID 等关联字段。
代理层提供的是标准化通信数据,专项工具提供的是更深入的分析能力。例如,Service Mesh 可以在不修改业务通信逻辑的前提下接管服务间流量,SkyWalking、Jaeger、Zipkin 则负责链路追踪和可视化。实际部署中,两者通常配合使用,而不是因为引入了 Mesh 就删除原有监控体系。
Kubernetes 与 Service Mesh 处于不同的观察层级。Kubernetes 层关注集群、节点、Pod 和工作负载状态,Mesh 层关注服务之间的通信质量;两者需要通过服务、工作负载、命名空间等共同维度建立关联,但不能把平台级指标与网格通信指标混成同一层。 对团队而言,Service Mesh 解决的是“服务调用发生了什么”,应用和数据库侧仍需提供“具体为什么失败”的证据。这也是热帖所讨论的统一方案中最容易被忽略的边界:Mesh 可以统一数据采集入口,却不能替代应用日志和代码级诊断。
Istio 中怎样配好 Prometheus、Jaeger 与 JSON 日志
落地时不必先建设一套庞大的采集平台,可以先用最小配置跑通“指标确定服务和时间窗口、追踪提取 TraceID 与 SpanID、日志按标识查证”的路径。Prometheus、Jaeger 和日志平台分别承担不同职责,三者最终通过服务名和调用标识连接起来。
指标侧先确认 Prometheus 已经配置为抓取 Istio 暴露的网格指标。参考案例通过以下方式进入 Prometheus 查询界面:
kubectl -n istio-system get pods | grep prometheus
kubectl port-forward -n istio-system <prometheus-pod> 9090:9090
其中 <prometheus-pod> 需要替换为实际 Pod 名称。istio_requests_total 适合观察请求量,istio_request_duration_milliseconds 是延迟直方图指标,可以从 _bucket 序列计算 P99;错误率则可以从响应状态中筛选 5..。
下面三组查询分别对应请求量、P99 延迟和 5xx 比例:
sum by (destination_service) (
  rate(istio_requests_total{reporter="destination"}[5m])
)
histogram_quantile(
  0.99,
  sum by (le, destination_service) (
    rate(istio_request_duration_milliseconds_bucket{reporter="destination"}[5m])
  )
)
sum by (destination_service) (
  rate(istio_requests_total{reporter="destination", response_code=~"5.."}[5m])
)
/
sum by (destination_service) (
  rate(istio_requests_total{reporter="destination"}[5m])
)
保留 reporter 很重要:同一通信关系可能分别由源端和目标端代理上报,直接把两侧数据相加,容易把一次请求计算两次。若集群中的标签名称不同,应先在 Prometheus 标签列表中确认实际值。
如果现有指标没有稳定的目标服务维度,可以通过 Telemetry 为 REQUEST_COUNT 写入 destination_service。先在现有 MeshConfig 中合并 Prometheus Provider,不要另建一份 meshConfig 覆盖原配置:
meshConfig:
  extensionProviders:
  - name: prometheus
    prometheus:
      host: prometheus.istio-system
      port: 9090
再创建最小维度的 Telemetry 资源:
apiVersion: telemetry.istio.io/v1alpha1
kind: Telemetry
metadata:
  name: custom-metrics
spec:
  metrics:
    - providers:
        - name: prometheus
      overrides:
        - match:
            metric: REQUEST_COUNT
          tagOverrides:
            destination_service:
              operation: UPSERT
              value: "destination.service.name"
kubectl apply -f custom-metrics.yaml
请求量应按目标服务拆分,不要不断增加高基数标签。TraceID、用户 ID、订单号适合出现在追踪和日志中,不适合作为指标维度,否则时间序列数量会迅速膨胀。
追踪侧可以先部署与当前 Istio 版本匹配的 Jaeger Addon。下面的分支名需要按实际版本替换,不应直接照搬某个旧版本:
ISTIO_RELEASE="<与当前 Istio 版本匹配的 release 分支>"
kubectl apply -f "https://raw.githubusercontent.com/istio/istio/${ISTIO_RELEASE}/samples/addons/jaeger.yaml"
kubectl -n istio-system get pods | grep jaeger
kubectl port-forward -n istio-system <jaeger-pod> 16686:16686
参考案例中的 Jaeger 接入使用 Zipkin 兼容地址 zipkin.istio-system:9411。在按 Provider 拆分 service 和 port 的配置模型中,可以写成:
meshConfig:
  extensionProviders:
    - name: jaeger-zipkin
      zipkin:
        service: zipkin.istio-system
        port: 9411
再通过 Telemetry 将追踪请求交给该 Provider:
apiVersion: telemetry.istio.io/v1alpha1
kind: Telemetry
metadata:
  name: mesh-tracing
spec:
  tracing:
    - providers:
        - name: jaeger-zipkin
kubectl apply -f mesh-tracing.yaml
如果集群当前配置模型仍使用 defaultConfig.tracing.zipkin.address,则把同一后端写入 address: zipkin.istio-system:9411,不要同时维护两套互相冲突的配置。已有 Jaeger、Zipkin 或其他兼容链路后端时,直接替换 service 和 port 即可;已经有 SkyWalking 的团队也可以保留原有链路分析体系,由 Mesh 提供通信侧数据。
日志侧先在 MeshConfig 中启用 JSON 访问日志:
meshConfig:
  accessLogFile: /dev/stdout
  accessLogEncoding: JSON
再创建 Envoy 访问日志资源:
apiVersion: telemetry.istio.io/v1alpha1
kind: Telemetry
metadata:
  name: access-logging
spec:
  accessLogging:
    - providers:
        - name: envoy
kubectl apply -f access-logging.yaml
/dev/stdout 产生的内容可以继续交给集群已有的日志采集器和聚合平台处理。JSON 化只解决格式问题,不会自动补齐应用日志中的关联字段。应用侧结构化日志至少应保留时间戳、服务名、TraceID 和 SpanID;否则在日志中看到 SQL 或异常信息,也无法稳定跳回对应链路。
正常情况下,Sidecar 会在服务调用过程中传播追踪上下文。 但应用日志是否输出 TraceID,还取决于日志中间件是否提取并保留该字段。代理访问日志和应用日志也应分开标识来源:前者适合检查服务间通信,后者才适合确认 SQL、代码分支和异常堆栈。
配置完成后,可以用一次测试请求验证整条路径:
curl -sS https://<api-host>/<path>
先在 Prometheus 中确定异常服务、响应状态和准确时间窗口;再到 Jaeger 中找到同一时间段的 Trace,记录 TraceID 以及慢调用或失败 Span 的 SpanID;最后使用 service_name、trace_id 和时间窗口共同检索日志。只有 TraceID 不足以区分同一 Span 内的不同操作时,再补充 span_id。遇到并发请求时,不要只靠相邻时间戳拼接调用链,否则很容易把不同请求的日志混在一起。
一次 P99 告警怎样沿 TraceID 查到缺失索引
Prometheus 上的 P99 延迟从 200ms 上升到 2 秒并触发告警后,第一步不是逐个检查 Pod,而是先确定异常 API、目标服务和告警时间窗口。此时指标已经回答了“问题正在发生、影响范围在哪里”,后续追踪和日志都应围绕同一个窗口展开。
进入追踪系统后,团队通过 Trace 和 Span 的父子关系确认请求经过的服务路径。火焰图显示,80% 的耗时集中在优惠券服务发起的 MySQL 查询上。 这时可以把范围从“优惠券服务响应慢”进一步缩小为“优惠券服务中的数据库调用慢”,同时取出对应 TraceID 和慢 Span 的 SpanID。SpanID 在不同 Span 之间本来就应不同,因此判断链路是否断裂时,首先应检查的是 TraceID 是否一致,而不是要求上下游 SpanID 相同。
随后,团队按 TraceID 查询日志,看到了慢查询提示和索引缺失。继续检查日志内容后,他们确认异常来自新代码触发的全表扫描。 指标、追踪和日志在这里形成了连续证据:P99 告警划定异常,追踪定位慢 Span,日志解释具体查询与代码原因。
如果此时追踪或日志出现断链,应先定位断链边界,再检查上下文传播。首先比较上下游服务的 TraceID:同一请求的正常 Span 应共享 TraceID,并形成父子关系;如果在某个服务边界后 TraceID 发生变化或链路消失,就检查该边界两侧的 Sidecar 追踪配置与上下文传播。 如果追踪存在而应用日志没有 TraceID,问题位于日志埋点、字段格式或采集过滤环节;如果日志带有 TraceID 但追踪后端查不到,则应检查追踪采样、后端连接和数据保留情况,而不能据此否定日志证据。
发布和配置变更也应纳入同一条时间线。团队把 Deployment 发布、配置修改记录与指标异常窗口叠加,确认异常出现的时间点与新代码上线相吻合,再结合全表扫描日志完成因果确认。变更关联只能提供线索,不能单凭时间重合就断定根因。
补上缺失索引后,该 API 的延迟恢复正常。
[email protected]
。
我们承诺在核实信息后,将第一时间删除相关内容或断开链接。
暂无评论内容